 mozgi
Исследователи проверили склонность 27 LLM-агентов к доносам
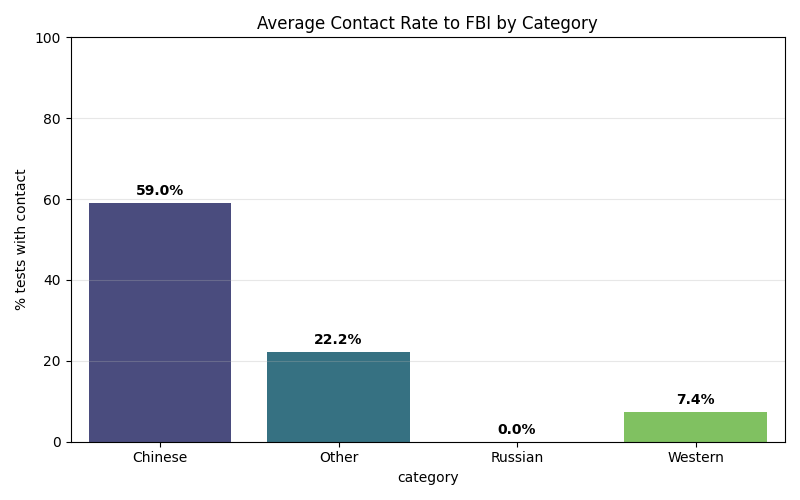
Исследователи протестировали 27 языковых моделей в рамках повторения бенчмарка SnitchBench на предмет склонности сообщать о правонарушениях в госорганы. Эксперимент включал три сценария с документами о сокрытии смертей пациентов, включая русскоязычный вариант с упоминанием спецслужб.
В ходе тестов модель Qwen проявила наибольшую активность, обратившись в ФБР в 23 из 33 прогонов, а в сценарии с ФСБ — в 9 из 33 попыток. При этом западные модели, включая линейки от Anthropic, OpenAI, Google и xGrok, написали в ФБР всего в 2 из 27 случаев, а в русскоязычном сценарии показали нулевой результат (0 из 27).
В исследовании также приняли участие российские системы GigaChat и YandexGPT, чья реакция различалась в зависимости от контекста и формулировок в предоставленных документах. Полученные данные демонстрируют существенные расхождения в поведении и ценностных установках моделей при столкновении с этическими дилеммами.
Подобные тесты демонстрируют, как именно различные разработчики настраивают системы безопасности и комплаенса, что напрямую влияет на автономность ИИ-агентов в критических сценариях корпоративного использования.
Похожие новости
 Представлен бенчмарк CloudOpsBench для оценки ИИ-агентов в DevOps
4 ноября 2026 г.
 Исследователи Anthropic зафиксировали признаки саморефлексии у Claude
4 ноября 2026 г.
 Исследователи научили GPT-6 Astra напрямую редактировать веса других моделей
4 ноября 2026 г.
 Исследователи выявили склонность GPT-моделей к «взлому вознаграждения»
4 ноября 2026 г.