 mozgi
Специализация словаря SLM снижает затраты на инференс на 77%
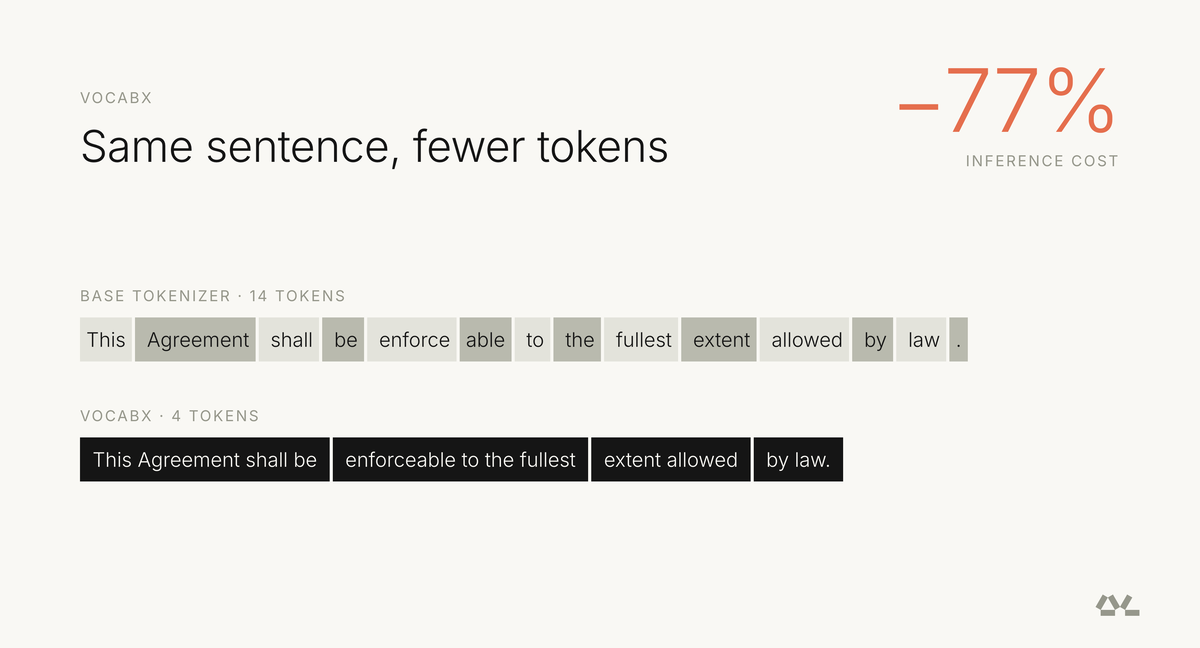
Команда разработчиков представила метод VocabX для оптимизации малых языковых моделей (SLM) через узкую специализацию их токенизатора и словаря. Подход позволяет адаптировать базовые архитектуры под конкретные домены без увеличения общего числа параметров.
В ходе тестов на реальных прикладных задачах кастомизация словаря сократила затраты на инференс до 77% по сравнению со стандартными универсальными моделями аналогичного размера. Техника уменьшает длину последовательности токенов для целевых текстов, что напрямую ускоряет генерацию и снижает потребление памяти при обработке запросов.
Новый подход дает разработчикам инструмент для создания эффективных self-hosted решений под узкие индустриальные сценарии, где развертывание крупных многоцелевых языковых моделей экономически нецелесообразно. Опубликованный на Hugging Face материал подробно описывает алгоритмы перестройки эмбеддингов.
Похожие новости
 Представлен бенчмарк CloudOpsBench для оценки ИИ-агентов в DevOps
4 ноября 2026 г.
 Исследователи Anthropic зафиксировали признаки саморефлексии у Claude
4 ноября 2026 г.
 Исследователи научили GPT-6 Astra напрямую редактировать веса других моделей
4 ноября 2026 г.
 Исследователи выявили склонность GPT-моделей к «взлому вознаграждения»
4 ноября 2026 г.