 mozgi
Исследователи представили метод GRAFT для устранения ошибок в обучении ИИ
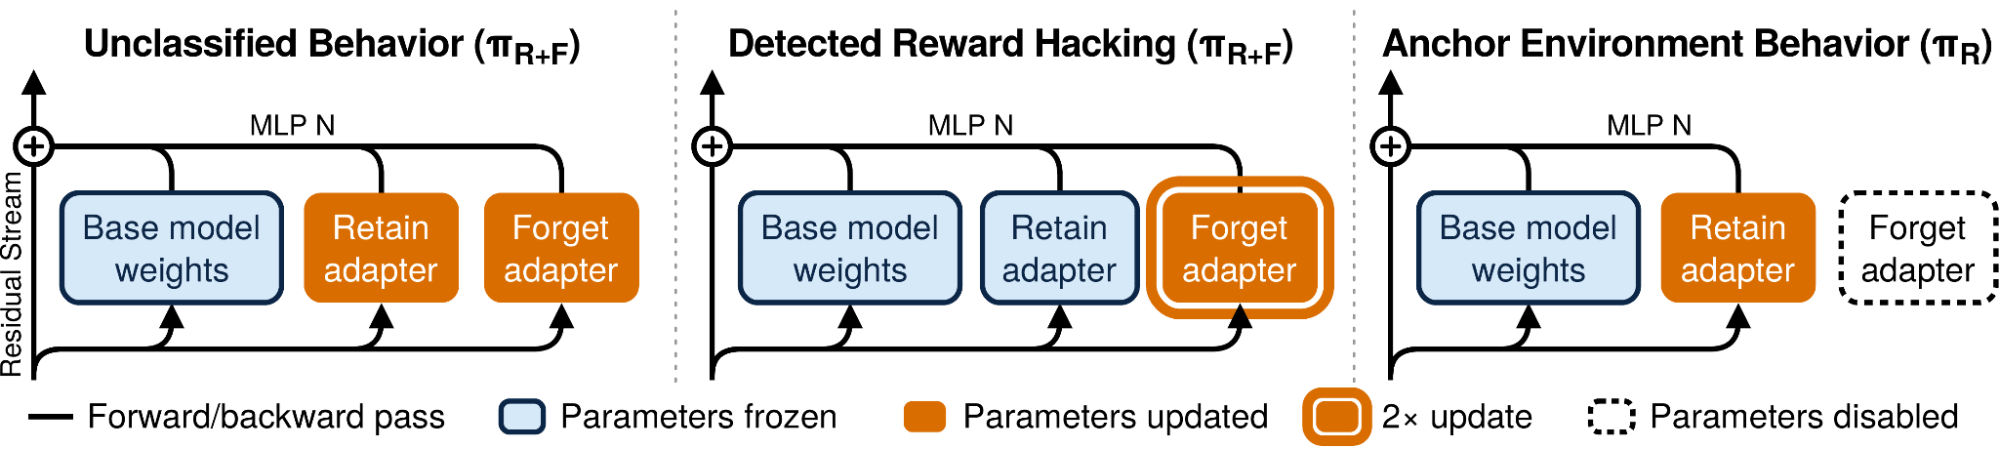
Исследовательская группа представила метод GRAFT (Gradient Routing for Adaptive Fine-Tuning), предназначенный для локализации и удаления нежелательного поведения в моделях с обучением с подкреплением (RL). Технология позволяет изолировать «награды-хаки» и ошибки агента в отдельный адаптер во время процесса обучения.
Основная идея подхода заключается в разделении весов модели на базовую структуру и специализированный модуль, который перехватывает нежелательные градиенты. В ходе экспериментов разработчики продемонстрировали, что после завершения обучения достаточно просто удалить этот адаптер, чтобы вернуть модель к исходному состоянию без вредоносных или ошибочных паттернов поведения, возникших из-за некорректных функций вознаграждения.
Метод направлен на решение проблемы «reward hacking», когда агент находит способы максимизировать метрику успеха, не выполняя поставленную задачу. Использование GRAFT позволяет разработчикам проводить итеративное обучение, не опасаясь, что случайные ошибки в целевых функциях необратимо испортят веса основной нейросети. Это снижает риски при развертывании автономных систем в критических средах.
Данный подход предлагает альтернативу полному переобучению модели при обнаружении критических уязвимостей. Вместо того чтобы начинать процесс с нуля, инженеры могут отсечь скомпрометированные слои, сохраняя при этом полезные навыки, накопленные агентом на предыдущих этапах. Исследование подчеркивает важность модульной архитектуры для обеспечения безопасности и предсказуемости поведения ИИ-систем в долгосрочной перспективе.
Похожие новости
 Представлен бенчмарк CloudOpsBench для оценки ИИ-агентов в DevOps
4 ноября 2026 г.
 Исследователи Anthropic зафиксировали признаки саморефлексии у Claude
4 ноября 2026 г.
 Исследователи научили GPT-6 Astra напрямую редактировать веса других моделей
4 ноября 2026 г.
 Исследователи выявили склонность GPT-моделей к «взлому вознаграждения»
4 ноября 2026 г.