 mozgi
DeepSeek выпустила экономичную модель DeepSeek v4.1 Flash
17 октября 2026 г.
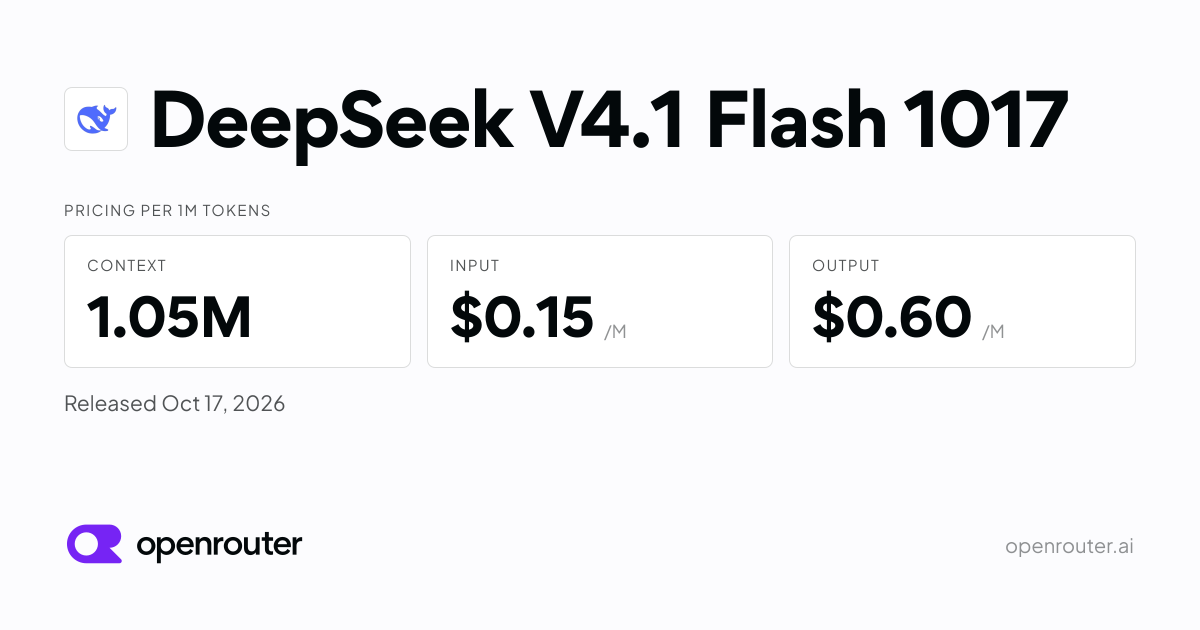
Команда DeepSeek представила новую языковую модель DeepSeek v4.1 Flash 1017. Новинка ориентирована на высокую скорость работы и снижение затрат на инфраструктуру.
Архитектура построена на принципах разреженной смеси экспертов (sparse MoE). Модель обладает возможностями нативного понимания изображений и поддерживает встроенное кеширование ключей и значений (KV caching).
Производительность решения достигает 150 токенов в секунду. Стоимость использования составляет $0.15 за 1 миллион входных токенов и $0.60 за 1 миллион выходных токенов.
Выпуск модели расширяет линейку доступных инструментов для разработчиков, желающих оптимизировать расходы на генерацию текста и обработку мультимодальных данных в продакшене.
Похожие новости
 Moonshot AI выпустила модель Kimi K3.1 Pro с контекстом в 1 млн токенов
4 ноября 2026 г.
Tencent представила языковую модель Hy4
4 ноября 2026 г.
OpenAI запустила модель GPT-5.6 Cyber в AWS GovCloud
4 ноября 2026 г.
 Представлена Kronos — специализированная модель для анализа финансовых графиков
3 ноября 2026 г.