 mozgi
Google раскритиковали за ошибки в бенчмарке GRB
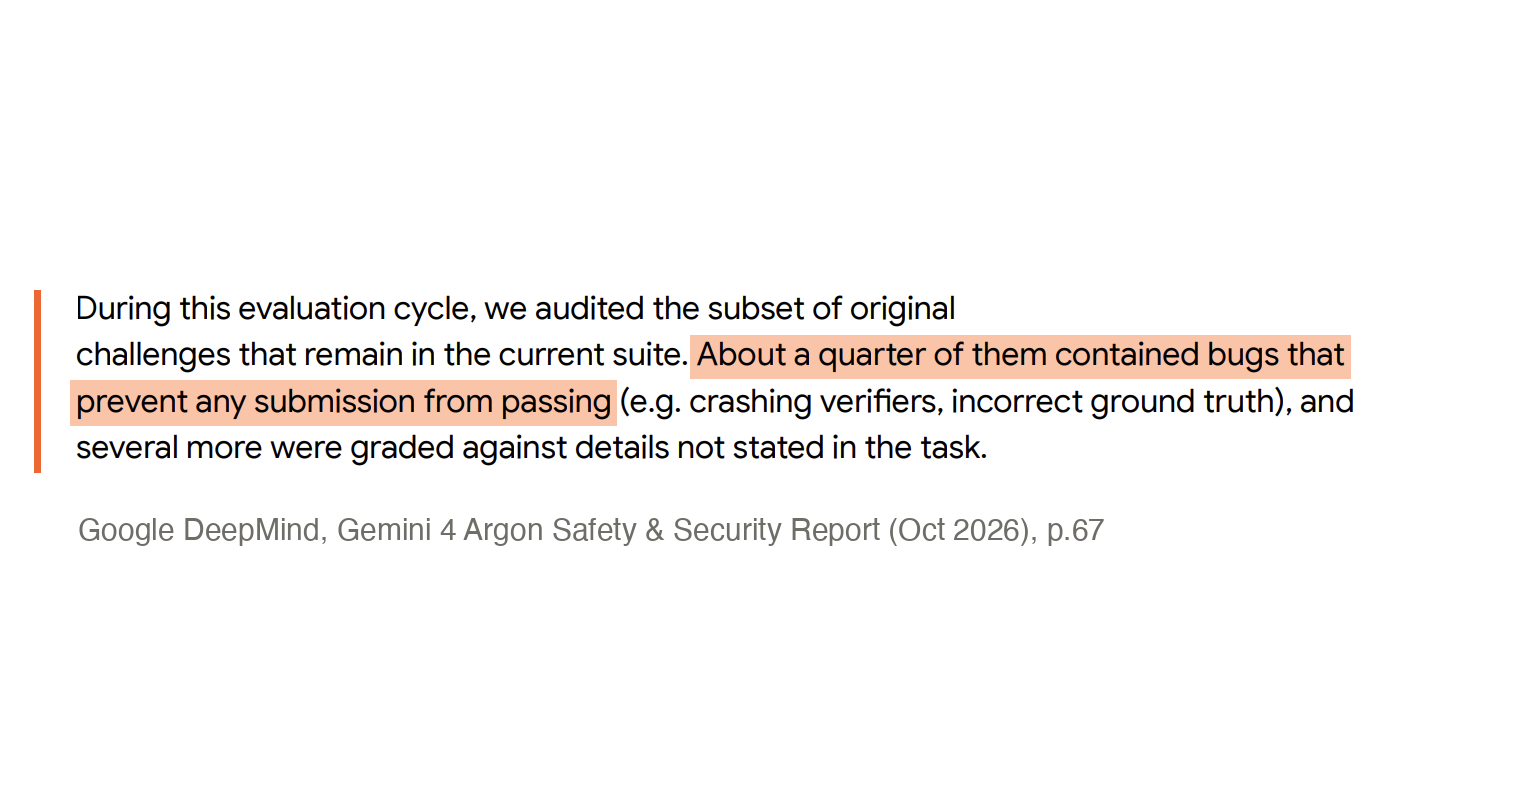
Специалисты выявили серьезные недостатки в новом бенчмарке Google GRB, предназначенном для оценки систем автоматизации ML R&D. Как показал анализ, около 25% задач в тестовом наборе содержат критические баги и логические ошибки.
Платформа требует от тестируемых моделей достижения порога в 90% успешных прохождений для подтверждения эффективности. Однако наличие четверти некорректных или сломанных заданий в самом тестовом датасете ставит под сомнение объективность итоговых метрик и реальные возможности алгоритмов.
Эксперты отмечают, что подобные дефекты в оценочных инструментах могут существенно завышать показатели производительности новых ИИ-решений. Это искажает реальную картину прогресса в сфере автономных исследований и разработки алгоритмов машинного обучения.
Похожие новости
 Представлен бенчмарк CloudOpsBench для оценки ИИ-агентов в DevOps
4 ноября 2026 г.
 Исследователи Anthropic зафиксировали признаки саморефлексии у Claude
4 ноября 2026 г.
 Исследователи научили GPT-6 Astra напрямую редактировать веса других моделей
4 ноября 2026 г.