 mozgi
Anthropic выявила влияние инфраструктуры на результаты бенчмарков ИИ-агентов
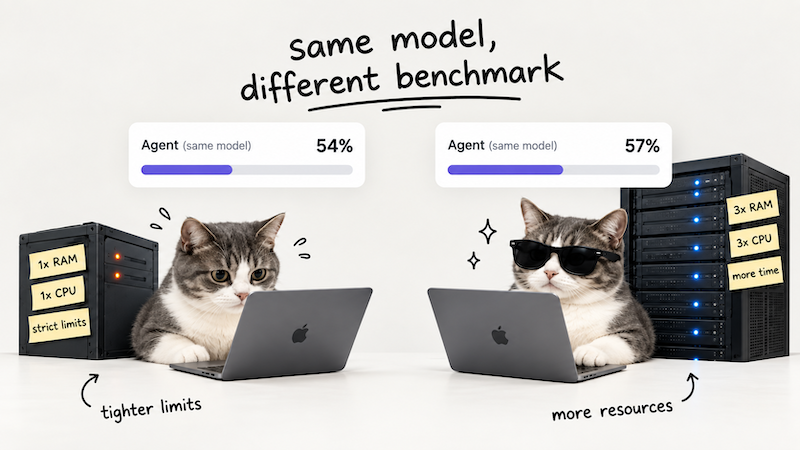
Компания Anthropic опубликовала результаты исследования, посвященного влиянию инфраструктурного шума на оценку производительности ИИ-агентов. В ходе тестов на платформе Terminal-Bench 2.0 специалисты проанализировали, как различные конфигурации среды исполнения кода влияют на итоговые показатели моделей.
Разница в результатах между строгими ограничениями и полностью открытой средой составила 6 процентных пунктов. Для сравнения, этот показатель превышает типичный разрыв между соседними позициями в верхней части актуальных рейтингов LLM. Исследование демонстрирует, что текущие методы оценки фиксируют не только способности самой модели, но и качество всей системы, в которой она функционирует.
Авторы работы подчеркивают, что при выполнении задач, требующих написания и запуска кода, внешние факторы — такие как доступность библиотек, задержки сети и настройки прав доступа — становятся критическими переменными. Эти параметры могут искусственно завышать или занижать баллы, полученные моделью в ходе тестирования.
Полученные данные указывают на необходимость стандартизации инфраструктурных условий при проведении бенчмарков. Без учета среды исполнения результаты сравнения различных архитектур могут быть нерелевантными, так как агент, работающий в более благоприятных условиях, будет выглядеть эффективнее конкурентов, несмотря на идентичные базовые возможности.
Похожие новости
 Представлен бенчмарк CloudOpsBench для оценки ИИ-агентов в DevOps
4 ноября 2026 г.
 Исследователи Anthropic зафиксировали признаки саморефлексии у Claude
4 ноября 2026 г.
 Исследователи научили GPT-6 Astra напрямую редактировать веса других моделей
4 ноября 2026 г.