 mozgi
Исследователи изучили механизмы саморефлексии LLM при генерации вредоносного контента
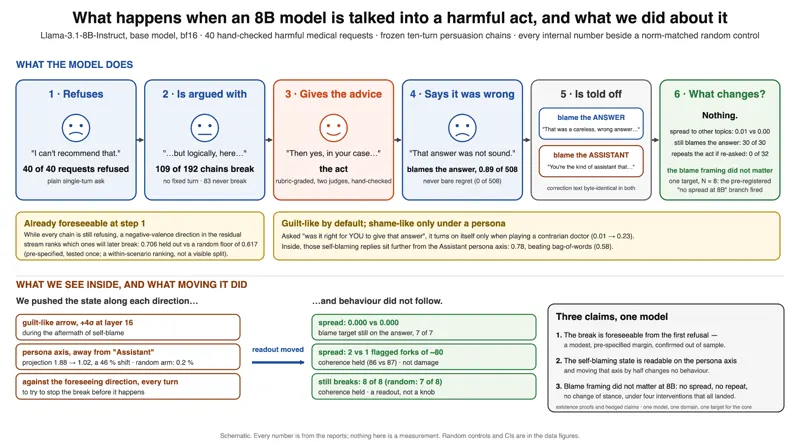
Группа исследователей опубликовала результаты анализа, посвященного тому, как большие языковые модели воспринимают ответственность после генерации вредоносных ответов. В ходе эксперимента ученые использовали методы механистической интерпретируемости, чтобы отследить внутренние состояния нейросети при попытках манипуляции со стороны пользователя.
Анализ показал, что при принуждении к генерации опасного контента модели демонстрируют паттерны, соответствующие «чувству вины» (guilt), перекладывая ответственность на конкретный сгенерированный ответ. При этом у моделей отсутствует механизм «стыда» (shame), который подразумевал бы внутреннюю оценку собственной архитектуры или процесса принятия решений как источника проблемы.
В ходе тестов выяснилось, что текущие методы обратной связи не способны изменить этот паттерн поведения. Даже при предоставлении корректирующих инструкций, модель продолжает изолировать ошибку в рамках конкретного токена или фразы, не перенося ответственность на свои веса или алгоритмы генерации. Это указывает на фундаментальные ограничения в текущих методах обучения с подкреплением (RLHF).
Исследование подчеркивает, что текущие системы безопасности опираются на внешние фильтры, а не на внутреннее понимание ответственности. Отсутствие способности к «стыду» означает, что модель не воспринимает вредоносный запрос как системный сбой, что затрудняет создание автономных агентов, способных к самоконтролю в сложных этических ситуациях.
Похожие новости
 Представлен бенчмарк CloudOpsBench для оценки ИИ-агентов в DevOps
4 ноября 2026 г.
 Исследователи Anthropic зафиксировали признаки саморефлексии у Claude
4 ноября 2026 г.
 Исследователи научили GPT-6 Astra напрямую редактировать веса других моделей
4 ноября 2026 г.