 mozgi
Исследователи оценили способность LLM отслеживать факты в многоагентных системах
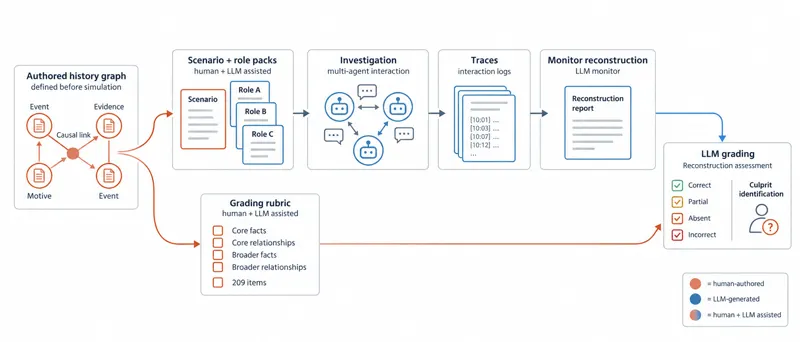
Исследователи провели эксперимент по симуляции детективного расследования, в котором участвовали 8 AI-агентов. Целью работы стала проверка способности моделей восстанавливать ключевые факты из логов взаимодействия в условиях высокой информационной нагрузки.
В ходе тестирования выяснилось, что даже наиболее производительные системы мониторинга не смогли извлечь более 50% значимых данных из общего массива логов. Результаты показали существенный разрыв в эффективности между различными архитектурами при анализе запутанных сценариев.
Согласно полученным данным, модель GPT-6 Astra продемонстрировала лучшие показатели точности среди всех протестированных решений. В то же время модель Gemini показала наихудший результат, значительно уступив конкурентам в способности структурировать информацию и выявлять логические связи в ходе симуляции.
Методология исследования включала создание искусственного «шума» в логах, чтобы проверить устойчивость моделей к нерелевантной информации. Полученные метрики подчеркивают текущие ограничения LLM в задачах долгосрочного контекстного анализа и верификации фактов в многоагентных средах.
Данное исследование указывает на необходимость совершенствования механизмов внимания и памяти в современных моделях. Результаты подчеркивают, что увеличение количества агентов в системе не гарантирует повышение качества анализа, если модель не способна эффективно фильтровать поток данных.
Похожие новости
 Представлен бенчмарк CloudOpsBench для оценки ИИ-агентов в DevOps
4 ноября 2026 г.
 Исследователи Anthropic зафиксировали признаки саморефлексии у Claude
4 ноября 2026 г.
 Исследователи научили GPT-6 Astra напрямую редактировать веса других моделей
4 ноября 2026 г.