 mozgi
Разработчики представили стандарт кодирования UTF-8000
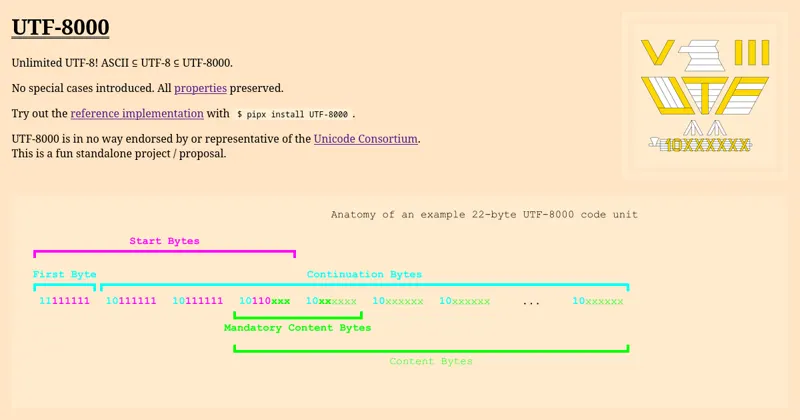
Разработчики выпустили UTF-8000 — расширение стандартной кодировки UTF-8, предназначенное для поддержки произвольно больших кодовых единиц. Проект решает проблему ограничений текущего стандарта при работе с экстремально длинными последовательностями данных.
Технология реализует механизм распределения начальных битов по байтам продолжения. Это позволяет кодировать данные любого размера, сохраняя при этом полную обратную совместимость с ASCII и базовыми свойствами UTF-8. Инструмент уже доступен для интеграции через менеджер пакетов pipx.
Реализация стандарта ориентирована на системы, требующие обработки нестандартных символьных наборов или специфических форматов данных, выходящих за рамки спецификации Unicode. Исходный код и документация проекта опубликованы на официальном сайте, где также ведется обсуждение технических аспектов внедрения UTF-8000 в существующие программные среды.
Внедрение данного стандарта позволяет разработчикам обходить ограничения на длину кодовых последовательностей без необходимости перехода на альтернативные методы сериализации. Это упрощает работу с высоконагруженными системами, где требуется передача данных, превышающих стандартные лимиты кодирования.
Похожие новости
 Nothing анонсировала выход AI-гаджета в следующем месяце
4 ноября 2026 г.
 AT&T интегрировала Gemini for Home в систему безопасности Connected Life
4 ноября 2026 г.
 OpenAI добавила генерацию GIF в ChatGPT с моделью Images 2.6
4 ноября 2026 г.
 Replay внедрила отладку с путешествием во времени для ИИ-агентов
4 ноября 2026 г.