 mozgi
Выпущен движок Laya-MLX для локального запуска моделей на Apple Silicon
Разработчики представили Laya-MLX — специализированный движок для локального инференса типизированных моделей принятия решений, таких как Laya. Инструмент оптимизирован для работы на устройствах с архитектурой Apple Silicon и не требует наличия PyTorch или подключения к облачным API.
Архитектура движка обеспечивает высокую скорость обработки данных при выполнении вычислений непосредственно на чипах Apple. Согласно техническим характеристикам, задержка (latency) при обработке англоязычных запросов составляет 13.4 мс. Для многоязычных входных данных показатель производительности достигает 7.4 мс.
Проект распространяется с открытым исходным кодом, что позволяет интегрировать его в локальные приложения без необходимости использования сторонних облачных инфраструктур. Использование нативного фреймворка MLX от Apple позволяет эффективно распределять нагрузку между ядрами CPU и GPU, минимизируя потребление оперативной памяти.
Релиз ориентирован на разработчиков, создающих системы автоматизированного принятия решений, где критически важна минимальная задержка отклика. Отказ от тяжелых зависимостей делает движок пригодным для встраивания в легковесные десктопные приложения, работающие в режиме реального времени на macOS.
Похожие новости
 Nothing анонсировала выход AI-гаджета в следующем месяце
4 ноября 2026 г.
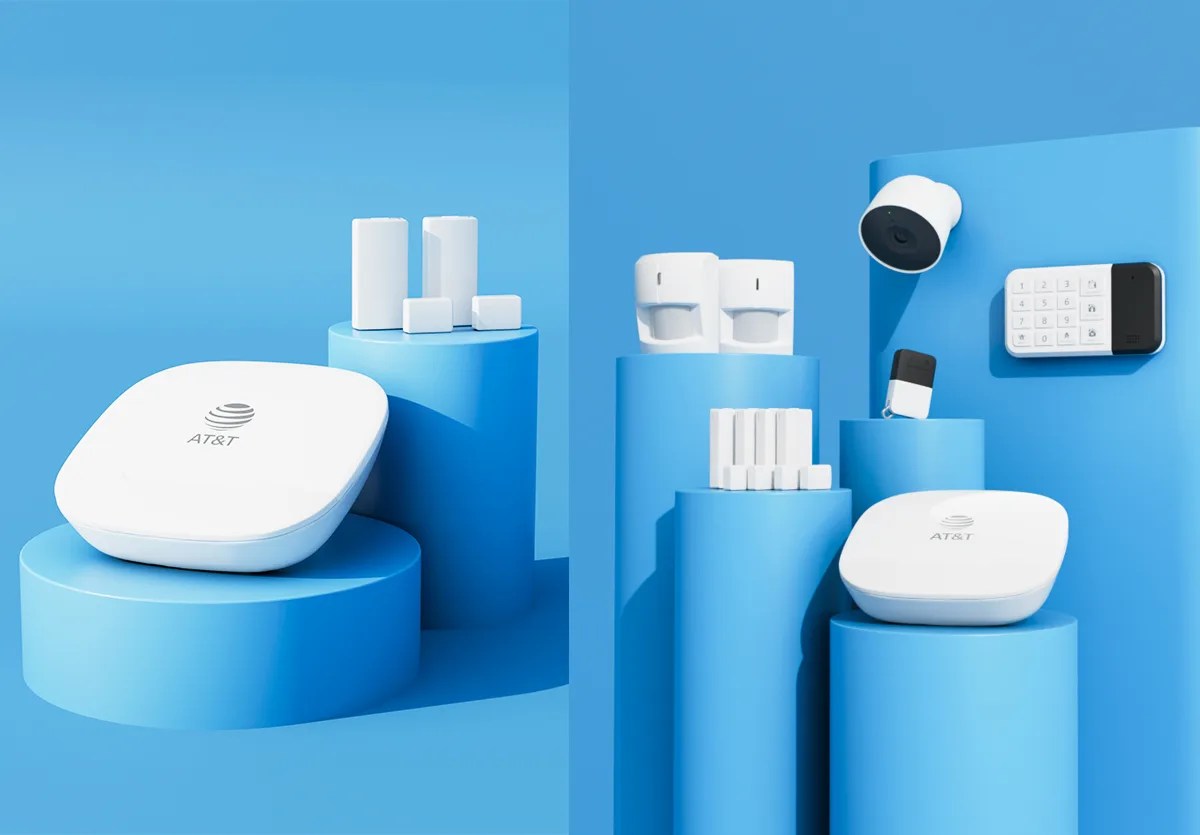 AT&T интегрировала Gemini for Home в систему безопасности Connected Life
4 ноября 2026 г.
 OpenAI добавила генерацию GIF в ChatGPT с моделью Images 2.6
4 ноября 2026 г.
 Replay внедрила отладку с путешествием во времени для ИИ-агентов
4 ноября 2026 г.