 mozgi
Hugging Face представила метод асинхронного обучения GRPO с LoRA
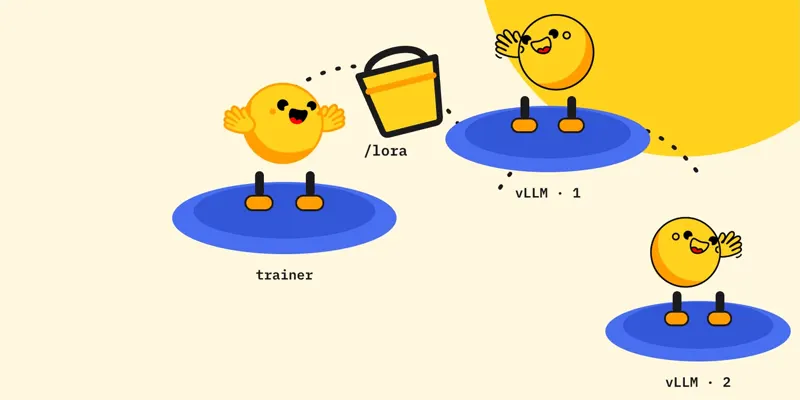
Команда Hugging Face опубликовала архитектурное решение для распределенного обучения моделей с использованием алгоритма GRPO (Group Relative Policy Optimization) и адаптеров LoRA. Метод позволяет проводить обучение без использования протокола NCCL, заменяя его на взаимодействие через объектное хранилище и прокси-сервер.
Основная проблема традиционного обучения заключается в жесткой синхронизации узлов, что приводит к простоям при выходе из строя одного из них. Новый подход использует асинхронную модель: каждый узел работает независимо, сохраняя промежуточные веса в облачный бакет. Это исключает необходимость в постоянном сетевом соединении между GPU, что критично для нестабильных кластеров.
В реализации используется LoRA для минимизации объема передаваемых данных. Вместо синхронизации полных весов модели, узлы обмениваются только градиентами адаптеров, что снижает нагрузку на сеть в десятки раз. Система протестирована на инфраструктуре HF Jobs, где удалось добиться стабильного обучения при динамическом подключении и отключении вычислительных мощностей.
Отсутствие зависимости от NCCL позволяет запускать обучение на гетерогенных GPU, которые не объединены в единую высокоскоростную сеть. Это решение снижает порог входа для дообучения больших языковых моделей, так как позволяет использовать разрозненные облачные инстансы без сложной настройки сетевой топологии.
Данный подход меняет подход к масштабированию обучения, делая процесс устойчивым к сбоям оборудования. Теперь разработчики могут запускать длительные циклы обучения, не опасаясь потери прогресса при прерывании работы отдельных узлов в кластере.
Похожие новости
 Nothing анонсировала выход AI-гаджета в следующем месяце
4 ноября 2026 г.
 AT&T интегрировала Gemini for Home в систему безопасности Connected Life
4 ноября 2026 г.
 OpenAI добавила генерацию GIF в ChatGPT с моделью Images 2.6
4 ноября 2026 г.
 Replay внедрила отладку с путешествием во времени для ИИ-агентов
4 ноября 2026 г.