 mozgi
Pyannote представила пайплайн для высокоточной диаризации речи
Разработчики pyannote.audio выпустили специализированный пайплайн speaker-diarization-precision, предназначенный для автоматического разделения аудиопотока по спикерам. Инструмент оптимизирует процесс транскрибации, позволяя точно определять, кто именно говорит в конкретный момент времени.
Система поддерживает функцию voiceprinting, которая создает уникальные акустические профили для каждого участника диалога. В процессе обработки данных модель присваивает каждому сегменту confidence scores, что позволяет пользователям фильтровать результаты по уровню уверенности алгоритма в идентификации говорящего.
Для интеграции в рабочие процессы предусмотрено развертывание в облачной инфраструктуре pyannoteAI. Это решение обеспечивает масштабируемость при обработке больших объемов аудиоданных, сохраняя при этом низкую задержку при выполнении задач сегментации в реальном времени.
Корпоративным клиентам доступна опция self-hosting, позволяющая развернуть пайплайн на собственных серверах. Такой подход обеспечивает полный контроль над данными и исключает необходимость передачи аудиофайлов во внешние облачные сервисы, что критично для соблюдения политик безопасности и конфиденциальности.
Внедрение данного инструмента позволяет автоматизировать создание протоколов встреч и анализ многоголосых записей. Использование специализированных моделей для диаризации снижает количество ошибок при последующей передаче текста в LLM для суммаризации или анализа контекста беседы.
Похожие новости
 Nothing анонсировала выход AI-гаджета в следующем месяце
4 ноября 2026 г.
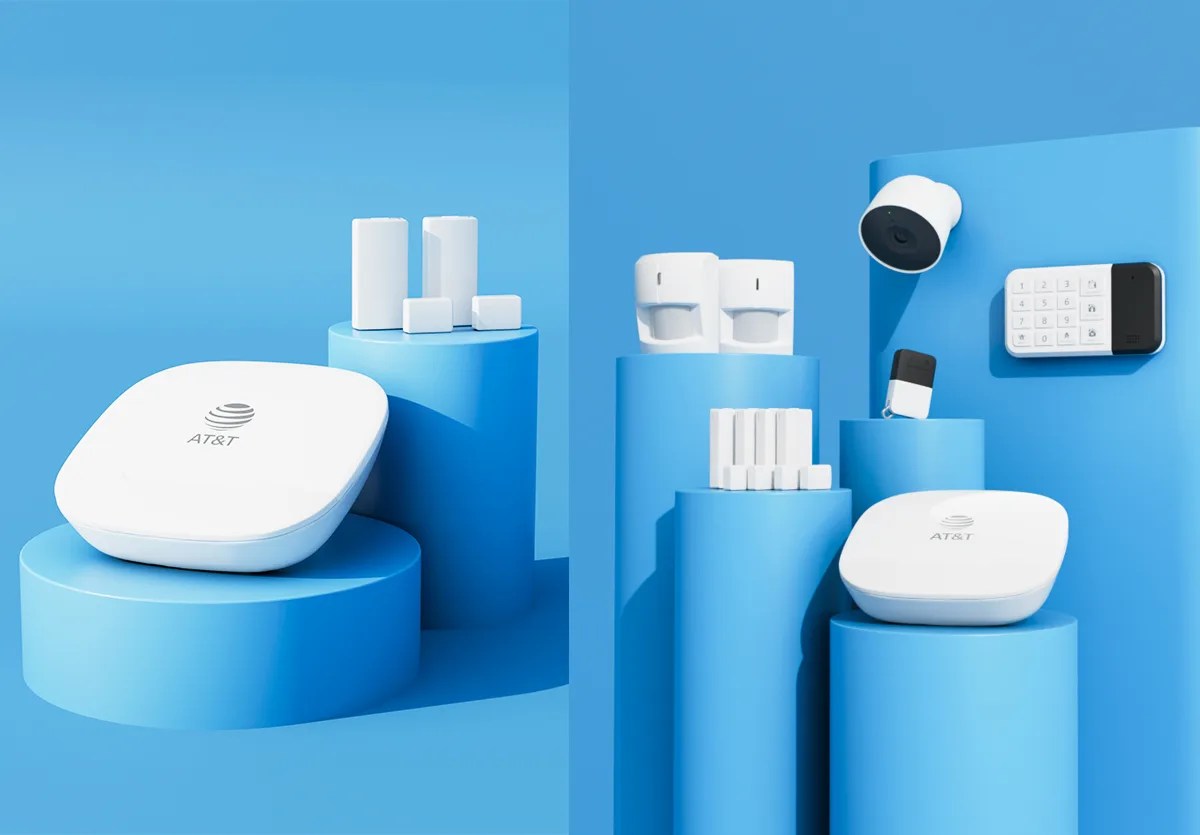 AT&T интегрировала Gemini for Home в систему безопасности Connected Life
4 ноября 2026 г.
 OpenAI добавила генерацию GIF в ChatGPT с моделью Images 2.6
4 ноября 2026 г.
 Replay внедрила отладку с путешествием во времени для ИИ-агентов
4 ноября 2026 г.