 mozgi
Разработчик дообучил модель GLiNER с помощью Gemini за 9 долларов
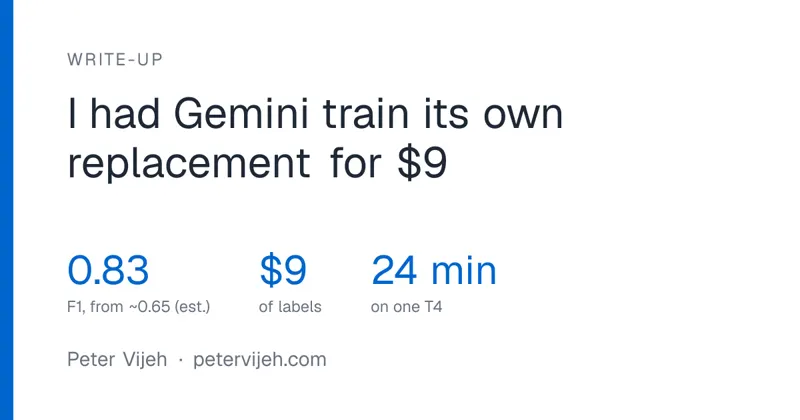
Разработчик реализовал процесс дообучения специализированной модели GLiNER, используя разметку, полученную от Gemini. Весь цикл подготовки данных и обучения занял 24 минуты, а общие затраты на API-запросы составили 9 долларов.
В результате удалось достичь показателя 0.83 F1-score при решении задачи распознавания именованных сущностей (NER) на специфических данных Reddit. Модель была оптимизирована для работы с комментариями, что позволило добиться высокой точности при минимальных вычислительных ресурсах. Согласно расчетам автора, стоимость разработки окупается после обработки 4 291 комментария.
Использование крупных языковых моделей для генерации синтетических размеченных данных становится эффективным способом создания компактных специализированных решений. Вместо использования тяжелых моделей для каждого запроса, дообученная модель GLiNER выполняет аналогичные функции с кратно меньшими затратами на инференс.
Данный подход демонстрирует возможность быстрого создания узкоспециализированных инструментов для анализа текста без необходимости ручной разметки больших датасетов. Перенос логики из облачных LLM в локальные или легковесные модели позволяет существенно снизить операционные расходы при масштабировании обработки данных.
Похожие новости
 Nothing анонсировала выход AI-гаджета в следующем месяце
4 ноября 2026 г.
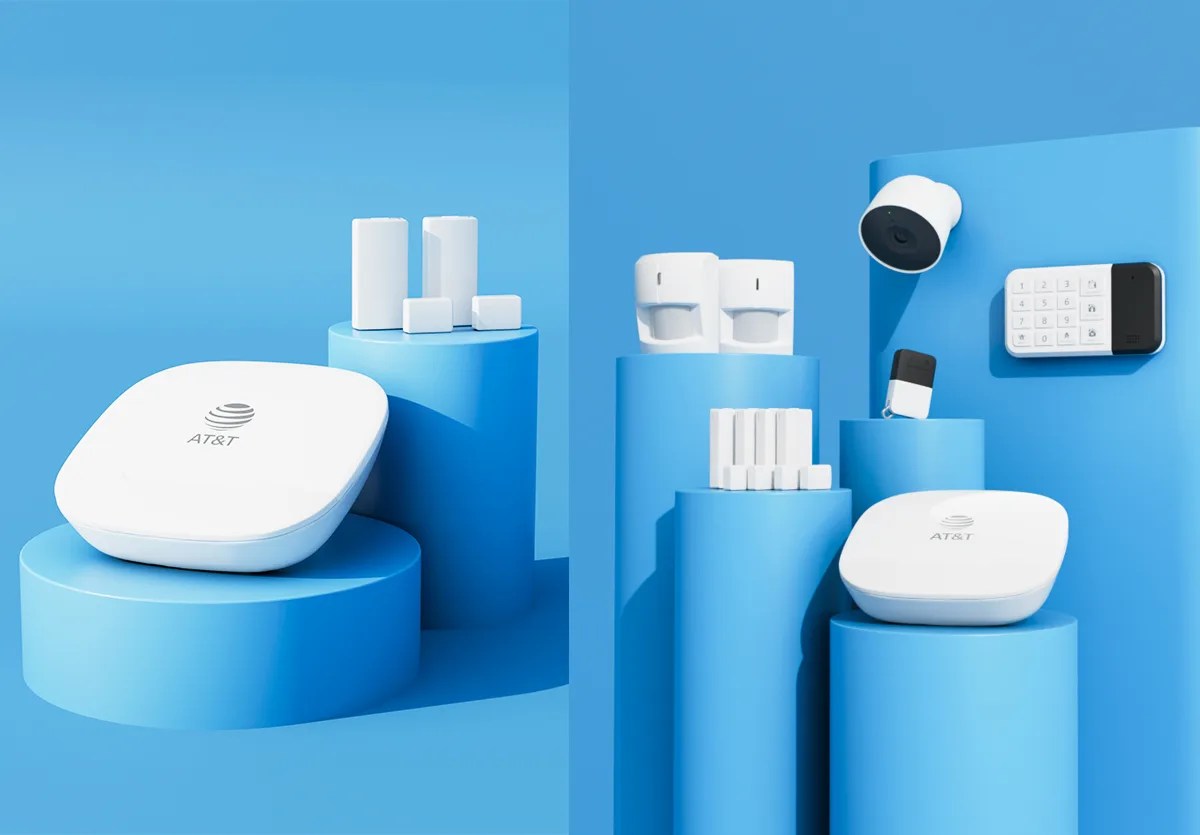 AT&T интегрировала Gemini for Home в систему безопасности Connected Life
4 ноября 2026 г.
 OpenAI добавила генерацию GIF в ChatGPT с моделью Images 2.6
4 ноября 2026 г.
 Replay внедрила отладку с путешествием во времени для ИИ-агентов
4 ноября 2026 г.