 mozgi
Linum представила архитектуру JiT-DDT для ускорения обучения моделей в 3.6 раза
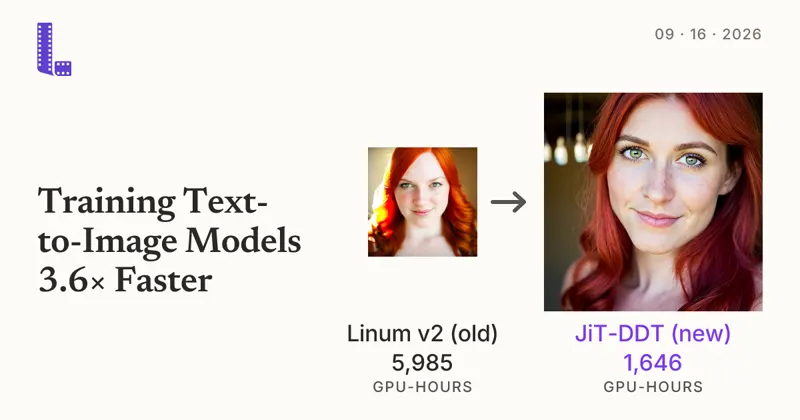
Компания Linum анонсировала новую архитектуру JiT-DDT, предназначенную для оптимизации процесса обучения генеративных моделей. Технология позволяет сократить время подготовки нейросетей для генерации изображений по текстовому описанию в 3.6 раза по сравнению со стандартными моделями диффузии (Latent Diffusion Models).
Ключевым отличием JiT-DDT является отказ от использования традиционного «бутылочного горлышка» в виде VAE (Variational Autoencoder). Вместо этого архитектура объединяет процессы сжатия и генерации в единую структуру. Система применяет агрессивное сжатие токенов до размера 32x32, что значительно снижает вычислительную нагрузку на этапе обучения.
Разработчики отмечают, что такой подход позволяет эффективно работать с пространственными данными без потери качества итоговой генерации. Интеграция сжатия непосредственно в архитектуру модели устраняет необходимость в предварительной обработке данных через внешние энкодеры, которые часто становятся узким местом при масштабировании обучения.
Новая архитектура направлена на снижение стоимости и времени разработки визуальных генеративных моделей. Использование JiT-DDT позволяет исследователям и инженерам проводить больше итераций обучения на том же аппаратном обеспечении, что критически важно для создания высокопроизводительных систем генерации изображений.
Похожие новости
 Представлен бенчмарк CloudOpsBench для оценки ИИ-агентов в DevOps
4 ноября 2026 г.
 Исследователи Anthropic зафиксировали признаки саморефлексии у Claude
4 ноября 2026 г.
 Исследователи научили GPT-6 Astra напрямую редактировать веса других моделей
4 ноября 2026 г.